


IOPS dysku to liczba operacji odczytu i zapisu, które dysk wykonuje w ciągu sekundy, opóźnienie (latencja) to czas oczekiwania jednej operacji, a przepustowość to megabajty na sekundę. Dla WordPressa i MySQL liczą się opóźnienie losowych odczytów 4 KB i czas fsync, bo czeka na nie każde zapytanie do bazy danych; reklamowane gigabajty na sekundę mają znaczenie tylko przy dużych plikach. Poniżej znajdziesz prawdziwe pomiary na maszynie wirtualnej w chmurze: fio, ioping, pułapkę dd oraz to, co fsync robi z MariaDB i z zapisywaniem wpisu w WordPressie.
Jak testowaliśmy
10 listopada 2026 roku na maszynie wirtualnej w chmurze, nie na serwerze RichHost: gość Firecracker, Ubuntu 24.04.5, 2 vCPU, 7,8 GB RAM, dysk virtio 256 GB z ext4. Nie wiadomo, jaki nośnik fizyczny stoi za tym dyskiem, a host może buforować dane, więc tych liczb nie da się przenieść na żaden inny hosting. Jako sufit posłużył tmpfs (system plików w RAM). Narzędzia: fio 3.36, ioping 1.3, dd, sysbench 1.0.20, MariaDB 10.11.14, WordPress 6.4.3. Każdy przebieg trwał od 15 do 20 sekund; maszyna jest współdzielona, dlatego zapisywaliśmy średnie obciążenie (load average, od 0,1 do 3,7). Parametry dysków pochodzą z oficjalnych kart katalogowych Samsunga i Seagate; dokumentację fio i MariaDB sprawdziliśmy 10.11.2026.
Trzy liczby i zależności między nimi
IOPS (operacje wejścia/wyjścia na sekundę) to liczba operacji. Sama w sobie nic nie znaczy bez rozmiaru bloku, wzorca dostępu (sekwencyjny czy losowy) i głębokości kolejki.
Opóźnienie to czas od żądania do odpowiedzi dla jednej operacji, w mikrosekundach lub milisekundach. Średnia nie wystarczy: patrz na 99. percentyl, bo najwolniejszy 1 % żądań użytkownicy odczuwają jako przycięcia.
Przepustowość mierzy się w megabajtach na sekundę i równa się IOPS razy rozmiar bloku. Na naszej maszynie testowej fio wykonało 20 578 losowych odczytów 4 KB na sekundę, czyli 80,4 MiB/s. Przy głębokości kolejki 1 działa to też w drugą stronę: IOPS to mniej więcej jeden podzielone przez opóźnienie, a 1 / 48 µs daje około 20 800 operacji. Jeśli trzy liczby w raporcie się nie zgadzają, test jest źle skonfigurowany.
Głębokość kolejki: dlaczego reklamy podają QD32, a strona żyje przy QD1
Głębokość kolejki (queue depth, QD) to liczba żądań, które jednocześnie czekają na dysk. Przy QD32 ten sam dysk VM dał 129 189 IOPS, 6,3 razy więcej niż przy QD1, ale każde żądanie czekało średnio 247 µs zamiast 48. Pojedynczy proces PHP wykonuje zapytania do bazy jedno po drugim, więc ładowanie jednej strony przypomina raczej QD1. Głębokie kolejki pojawiają się, gdy dziesiątki odwiedzających i zadań w tle jednocześnie korzystają z dysku, i właśnie wtedy dobre dyski odskakują od słabych.
Dlaczego WordPress i MySQL zależą od 4K i fsync, a nie od MB/s
InnoDB przechowuje dane w stronach po 16 KB i czyta je z rozproszonych miejsc pliku, czyli z dostępem losowym. Dopóki baza mieści się w buffer poolu (innodb_buffer_pool_size), odczyty idą z RAM, a dysk jest ledwie używany: w naszym teście sysbench 92 MB tabel mieściło się w buffer poolu o rozmiarze 256 MB. Dysk staje się wąskim gardłem, gdy baza przerośnie buffer pool albo gdy strona zapisuje dane.
Z zapisami jest inaczej. Domyślnie (innodb_flush_log_at_trx_commit=1) każda zatwierdzona transakcja wymusza zapis logu na dysk przez fsync, a zapytanie czeka, aż dysk to potwierdzi. WordPress działa w trybie autocommit, więc każdy INSERT czy UPDATE to osobna transakcja. Zmierzyliśmy typową czynność w panelu (opublikowanie wpisu z dwoma tagami i polem meta, a potem jego aktualizacja): od 95 do 102 zapytań SQL i od 16 do 18 wywołań fsync na jeden zapis. Koszyki, zamówienia, sesje, transienty i logi wtyczek zachowują się tak samo.
Strona oparta na bazie danych zależy więc od dwóch liczb: opóźnienia losowego odczytu 4K przy QD1 i opóźnienia zapisu z fsync. Sekwencyjne MB/s mają znaczenie przy kopiach zapasowych, archiwach i dużych plikach multimedialnych.
Wyniki fio: dysk VM w chmurze kontra tmpfs
Cztery profile, plik 1 GB, po 15 sekund, direct=1, żeby ominąć page cache jądra:
fio --name=rr1  --filename=./fio.dat --size=1G --runtime=15 --time_based --direct=1 \
    --rw=randread --bs=4k --ioengine=libaio --iodepth=1
fio --name=rr32 ... --rw=randread --bs=4k --ioengine=libaio --iodepth=32
fio --name=wfs  ... --rw=randwrite --bs=4k --ioengine=sync --fsync=1
fio --name=seq  ... --rw=read --bs=1M --ioengine=libaio --iodepth=8
| Profil | Dysk VM: IOPS | Dysk VM: MiB/s | Dysk VM: opóźnienie, średnio / p99 | tmpfs: IOPS |
|---|---|---|---|---|
| Odczyt losowy 4K, QD1 | 20 578 | 80,4 | 48 / 101 µs | 552 115 |
| Odczyt losowy 4K, QD32 | 129 189 | 504,6 | 247 / 692 µs | 546 572 |
| Zapis losowy 4K + fsync po każdym bloku | 9105 | 35,6 | zapis 40 µs + fsync 69 µs (fsync p99 169 µs) | 499 993 |
| Odczyt sekwencyjny 1M, QD8 | 2218 | 2218 | 3,6 ms | 5729 |
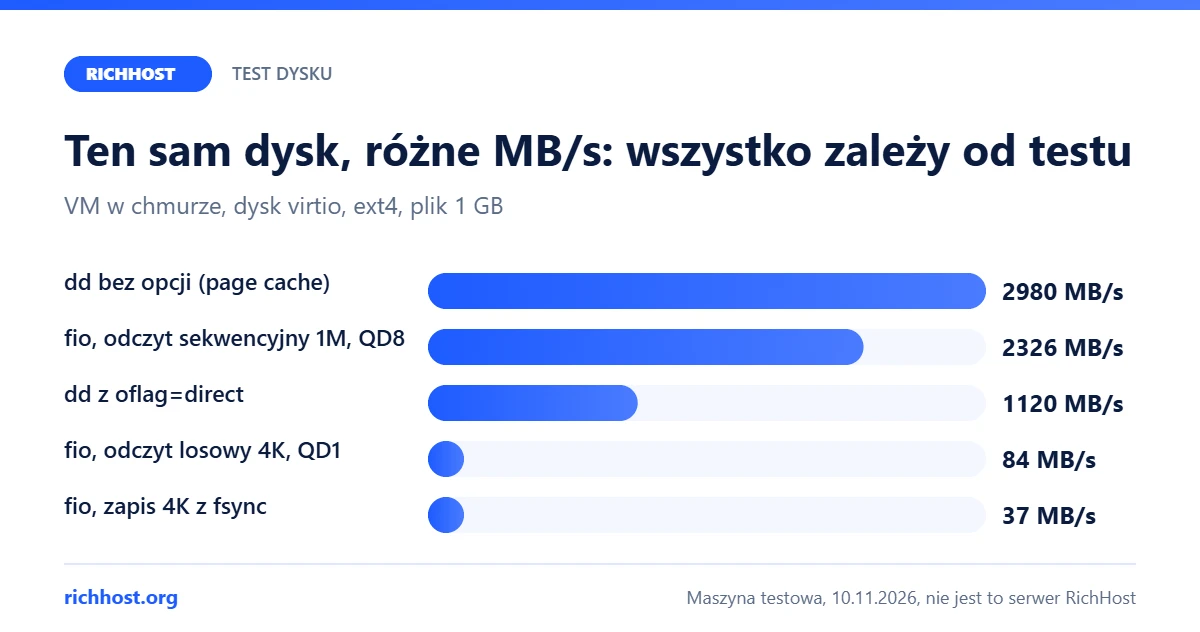
Średnie obciążenie wzrosło z 0,12 do 0,80 podczas testów dysku i utrzymywało się między 0,68 a 1,00 na tmpfs. Najważniejsze mieści się w jednym zdaniu: ten sam dysk daje 2218 MiB/s sekwencyjnie i tylko 35,6 MiB/s, gdy każdy blok 4 KB trzeba potwierdzić przez fsync. Powtórny test na pliku 4 GB pokazał jeszcze niższe opóźnienie (37 µs), co świadczy o buforowaniu po stronie hosta; goła pamięć NAND jest zwykle wolniejsza przy odczytach 4K. tmpfs pokazuje sufit bez żadnego dysku: opóźnienie wynosi tam kilka mikrosekund.
Ta sama różnica na wykresie (MiB/s z fio przeliczone na dziesiętne MB/s, tak jak podaje je dd):
Pułapka dd: 3 GB/s, których nie ma
dd if=/dev/zero wciąż bywa polecane jako „test dysku”. Oto co pokazuje na tym samym dysku (średnie obciążenie 0,47):
$ dd if=/dev/zero of=dd.test bs=1M count=1024
1073741824 bytes (1.1 GB, 1.0 GiB) copied, 0.360278 s, 3.0 GB/s
$ grep Dirty /proc/meminfo
Dirty:            516116 kB
$ dd if=/dev/zero of=dd.test bs=1M count=1024 conv=fdatasync
1073741824 bytes (1.1 GB, 1.0 GiB) copied, 0.952127 s, 1.1 GB/s
$ dd if=/dev/zero of=dd.test bs=1M count=1024 oflag=direct
1073741824 bytes (1.1 GB, 1.0 GiB) copied, 0.958656 s, 1.1 GB/s
$ dd if=dd.test of=/dev/null bs=1M        # read again
1073741824 bytes (1.1 GB, 1.0 GiB) copied, 0.141227 s, 7.6 GB/s
$ dd if=/dev/zero of=dd.test bs=4k count=5000 oflag=dsync
20480000 bytes (20 MB, 20 MiB) copied, 0.762809 s, 26.8 MB/s
Bez opcji dd zapisuje do page cache jądra i kończy pracę, zanim dane trafią na dysk: tuż po poleceniu w pamięci wciąż było 516 MB brudnych stron (dirty). Wynik jest zawyżony 2,7 razy. Ponowny odczyt pliku dał 7,6 GB/s, bo dane szły z RAM. Uczciwe opcje to conv=fdatasync lub oflag=direct przy zapisie i iflag=direct przy odczycie. Nawet poprawnie użyte dd mierzy tylko dostęp sekwencyjny. Ostatnia linia jest bliższa bazie danych: małe synchroniczne zapisy osiągnęły 26,8 MB/s. Jeszcze jedna pułapka: niektóre systemy pamięci masowej kompresują lub deduplikują zera z /dev/zero, przez co wynik wygląda jeszcze lepiej.
fsync w praktyce: MariaDB z innodb_flush_log_at_trx_commit 1 i 2
Wartość 1 (domyślna) zapisuje log na dysk przy każdym commicie. Wartość 2 zapisuje log przy commicie, ale synchronizuje go z dyskiem mniej więcej raz na sekundę; według dokumentacji MariaDB awaria systemu operacyjnego lub zanik zasilania może spowodować utratę transakcji z ostatniej sekundy. Porównaliśmy obie wartości za pomocą sysbench oltp_read_write (4 tabele po 100 000 wierszy, 20 sekund) oraz 40 zapisów wpisów w WordPressie:
| Test | flush = 1 | flush = 2 | Średnie obciążenie |
|---|---|---|---|
| sysbench, 1 wątek: transakcje/s, średnie opóźnienie | 545 i 575; 1,83 i 1,74 ms | 666 i 636; 1,50 i 1,57 ms | od 0,7 do 2,9 |
| sysbench, 4 wątki: transakcje/s, p95 | 1324; 5,18 ms | 1459; 5,09 ms | od 1,4 do 3,7 |
| wywołania fsync w 20 s (1 wątek) | 11 028 | 161 | |
| WordPress: średni czas zapisu (2 przebiegi) | 24,5 i 22,0 ms | 17,6 i 20,7 ms | od 1,8 do 1,9 |
| WordPress: fsync na zapis | od 16,5 do 18,1 | od 0,4 do 0,5 |
Liczba wywołań fsync spadła około 70 razy, a szybkość wzrosła tylko o 10 do 22 %. Powodem jest dysk testowy: fsync trwa na nim około 0,07 ms. Na dysku, na którym fsync trwa milisekundy, obraz się zmienia. Dla dysku HDD 7200 obr./min Seagate podaje średnie opóźnienie 4,16 ms, więc 17 wywołań fsync na zapis dodałoby około 70 ms lub więcej, a pojedynczy wątek bazy danych osiągnąłby najwyżej około 240 commitów na sekundę (1 / 4,16 ms). Dlatego na wolnym dysku WordPress ślimaczy się w panelu i przy składaniu zamówienia, a strona główna z cache nadal ładuje się szybko.
Wartość 2 ma sens tam, gdzie utrata sekundy danych przy awarii serwera jest do przyjęcia: kopie stagingowe, importy, blog bez zamówień. W sklepie przyjmującym płatności zostaw 1 i wybierz szybszy dysk. Na hostingu współdzielonym tylko dostawca może zmienić to ustawienie i słusznie: dotyczy ono wszystkich stron na serwerze.
NVMe, SSD SATA i HDD: co mówią karty katalogowe
Wybraliśmy po jednym popularnym modelu każdego typu. To wartości „do” z kart katalogowych producentów (sprawdzone 10.11.2026), zmierzone na ich własnych systemach testowych:
| Dysk | Odczyt sekwencyjny | Odczyt losowy, QD1 | Odczyt losowy, głęboka kolejka | Opóźnienie w specyfikacji |
|---|---|---|---|---|
| Samsung 990 PRO (NVMe, PCIe 4.0) | 7450 MB/s | 22 000 IOPS | od 1 200 000 do 1 400 000 IOPS (QD32, 16 wątków) | nie podano |
| Samsung 870 EVO (SSD SATA) | 560 MB/s | 13 000 IOPS (4 KB) | 98 000 IOPS (QD32) | nie podano |
| Seagate Exos X16 (HDD, 7200 obr./min) | 261 MB/s | nie podano | 170 IOPS (4K, QD16) | średnio 4,16 ms |
Najciekawsze jest QD1: NVMe wyprzedza SSD SATA 13 razy w odczycie sekwencyjnym, ale tylko 1,7 raza przy pojedynczych odczytach losowych. Przewaga NVMe ujawnia się przy głębokiej kolejce, gdy strona obsługuje wiele żądań naraz. HDD przegrywa z oboma o rzędy wielkości przy dostępie losowym: 170 operacji na sekundę nawet przy głębokości kolejki 16. Karty katalogowe dysków konsumenckich nie podają opóźnienia fsync, a ono mocno zależy od tego, czy dysk ma ochronę przed zanikiem zasilania, dzięki której może potwierdzać zapisy z własnej pamięci podręcznej. Dlatego fsync testuj samodzielnie.
Jak zmierzyć dysk na własnym VPS
Zainstaluj narzędzia (apt install fio ioping), przejdź do katalogu na partycji, na której leży baza danych (zwykle /var/lib/mysql), i uruchom krótkie testy. Potrzebujesz co najmniej 2 GB wolnego miejsca:
# latency: 20 requests of 4 KiB, bypassing the cache
ioping -c 20 -D .
# synchronous write latency
ioping -c 20 -W -Y .
# key for databases: 4K random read at QD1
fio --name=rr1 --filename=./fio.dat --size=1G --runtime=15 --time_based \
    --direct=1 --rw=randread --bs=4k --ioengine=libaio --iodepth=1
# 4K writes with fsync after every block
fio --name=wfs --filename=./fio.dat --size=1G --runtime=15 --time_based \
    --direct=1 --rw=randwrite --bs=4k --ioengine=sync --fsync=1
rm -f ./fio.dat
W raporcie fio patrz na IOPS=, clat (średnią oraz percentyle 99,00 i 99,90), a przy zapisie na blok fsync/fdatasync/sync_file_range. Na naszej maszynie ioping pokazał średnie opóźnienie odczytu od 123 do 210 µs i opóźnienie zapisu O_SYNC od 611 do 627 µs, z jednym skokiem do 54 ms. Wyniki ioping są wyższe niż fio, bo wysyła ono tylko kilka żądań na sekundę do dysku, który poza tym jest bezczynny; porównuj wyniki tylko z tego samego narzędzia.
Typowe błędy pomiaru
- dd bez direct ani fdatasync: mierzysz RAM.
- Test w /tmp: w wielu systemach to tmpfs, czyli znowu RAM.
- Porównywanie QD32 na jednym dysku z QD1 na innym: same ustawienia testu mogą dać kilkukrotną różnicę.
- Jeden krótki przebieg: na współdzielonym sprzęcie sąsiedzi i limity zmieniają wynik. Uruchom test 3 razy o różnych porach i sprawdź p99, nie tylko średnią.
- libaio bez
direct=1: według dokumentacji fio Linux kolejkuje żądania tylko przy niebuforowanym I/O, więciodepth=32tak naprawdę nie zadziała. - Plik testowy mniejszy niż cache hosta: w chmurze hiperwizor może buforować dysk, a wynik przebije możliwości samego nośnika.
Na hostingu współdzielonym zwykle nie ma fio, a długotrwałe obciążenie wspólnego dysku może uruchomić ukryte limity hostingu. Tam lepiej mierzyć to, co dostaje strona: czas do pierwszego bajtu (TTFB) stron bez cache i to, ile trwa zapisanie wpisu w panelu. Żeby sprawdzić zachowanie pod obciążeniem, przeprowadź ostrożnie testy obciążeniowe strony.
Jeśli X, zrób Y
| Jeśli | Zrób |
|---|---|
| Losowy odczyt 4K przy QD1 trwa średnio ponad 1 ms | To pamięć sieciowa albo HDD. Dla bazy danych szukaj lokalnego NVMe lub SSD; do tego czasu powiększ buffer pool InnoDB, żeby odczyty szły z RAM |
| Zapis 4K z fsync daje mniej niż 1000 IOPS | Licz się z wolnym panelem i procesem zamówienia. Ogranicz liczbę zapisów (object cache, porządki w opcjach autoload i transientach); dla niekrytycznych kopii rozważ flush 2 |
| dd pokazuje gigabajty na sekundę, a strona jest wolna | Powtórz test z oflag=direct i uruchom testy fio 4K: szybkość sekwencyjna niczego tu nie wyjaśnia |
| Średnie opóźnienie jest w porządku, ale p99 skacze do dziesiątek milisekund | Prawdopodobnie hałaśliwi sąsiedzi albo limit IOPS w Twoim planie. Powtórz pomiar o innych porach i zapytaj dostawcę o limity |
| Strona główna jest szybka; wolne są tylko wyszukiwanie, filtry i raporty | To zapytania bez indeksów, a nie dysk: zacznij od optymalizacji bazy danych |
| Serwer mocno zapisuje do swapu, gdy zwalnia | To problem z pamięcią: dysk jest zajęty swapem zamiast bazą danych. Przeczytaj o swapie i OOM killerze |
| Na dysku jest wolne miejsce, ale nie da się tworzyć plików | Sprawdź limit inodów, a nie szybkość |
| Korzystasz z hostingu współdzielonego i nie możesz uruchomić fio | Mierz TTFB stron bez cache i czas zapisu w panelu; przy wyborze planu zapytaj, jakich dysków używa |
W planach hostingowych RichHost strony działają na dyskach NVMe. Nie podajemy tu dla nich wartości IOPS: pomiary w tym artykule pochodzą z maszyny wirtualnej w chmurze, a nie z naszych serwerów.
FAQ
Ile IOPS potrzebuje strona na WordPressie?
Nie ma uniwersalnej liczby. Jeśli baza mieści się w buffer poolu, a strony są w cache, odczyty prawie nie docierają do dysku. Ważniejsze jest opóźnienie: na naszej maszynie jeden zapis wpisu wywołał od 16 do 18 wywołań fsync, więc gdy fsync trwa milisekundy, panel wyraźnie zwalnia nawet na małej stronie.
Czy można ufać testowi dd?
Tylko z oflag=direct lub conv=fdatasync i tylko jako oszacowaniu zapisu sekwencyjnego. Bez tych opcji dd pokazało na naszej maszynie 3,0 GB/s zamiast rzeczywistych 1,1 GB/s.
NVMe czy SSD SATA: czy mała strona odczuje różnicę?
Według kart katalogowych Samsunga pojedyncze odczyty losowe różnią się wynikiem 22 000 wobec 13 000 IOPS, czyli mniej niż dwukrotnie. NVMe wygrywa pod obciążeniem, gdy wiele żądań działa jednocześnie; HDD nie nadaje się do bazy danych.
Czy innodb_flush_log_at_trx_commit=2 jest bezpieczne?
Sama awaria MariaDB nie spowoduje utraty danych, ale awaria systemu operacyjnego lub zanik zasilania może kosztować transakcje z ostatniej sekundy. W sklepie przyjmującym płatności zostaw 1.
Dlaczego ioping i fio pokazują różne opóźnienia?
ioping wysyła kilka żądań na sekundę do bezczynnego dysku, a fio cały czas go obciąża. Porównuj dyski tym samym narzędziem i z tymi samymi parametrami.


