


Les IOPS indiquent combien d’opérations de lecture et d’écriture un disque effectue par seconde, la latence mesure combien de temps attend une seule opération, et le débit se compte en mégaoctets par seconde. Pour WordPress et MySQL, ce qui compte dans les IOPS et la latence du disque, c’est la latence des lectures aléatoires de 4 Ko et la durée de fsync, car chaque requête à la base de données les attend ; les gigaoctets par seconde mis en avant ne comptent que pour les gros fichiers. Voici de vraies mesures sur une machine virtuelle cloud : fio, ioping, le piège de dd, et ce que fsync change pour MariaDB et pour l’enregistrement d’un article dans WordPress.
Notre méthode
Le 10 novembre 2026, sur une machine virtuelle cloud et non sur un serveur RichHost : invité Firecracker, Ubuntu 24.04.5, 2 vCPU, 7,8 Go de RAM, un disque virtio de 256 Go en ext4. Le support physique derrière ce disque est inconnu et l’hôte peut mettre des données en cache : ces chiffres ne se transposent donc à aucun autre hébergement. Un tmpfs (un système de fichiers en RAM) a servi de plafond. Outils : fio 3.36, ioping 1.3, dd, sysbench 1.0.20, MariaDB 10.11.14, WordPress 6.4.3. Chaque essai a duré de 15 à 20 secondes ; la machine est partagée, nous avons donc noté la charge moyenne (load average, de 0,1 à 3,7). Les caractéristiques des disques proviennent des fiches techniques officielles de Samsung et Seagate ; documentation de fio et de MariaDB vérifiée le 10.11.2026.
Trois chiffres et leur lien
IOPS (opérations d’entrée/sortie par seconde) est un nombre d’opérations. Seul, il ne veut rien dire sans la taille de bloc, le type d’accès (séquentiel ou aléatoire) et la profondeur de file d’attente.
La latence est le temps entre la requête et la réponse pour une seule opération, en microsecondes ou en millisecondes. La moyenne ne suffit pas : regardez le 99e centile, car c’est le 1 % de requêtes les plus lentes que les utilisateurs ressentent comme des blocages.
Le débit se mesure en mégaoctets par seconde et vaut IOPS multiplié par la taille de bloc. Sur notre machine de test, fio a réalisé 20 578 lectures aléatoires de 4 Ko par seconde, soit 80,4 Mio/s. À une profondeur de file de 1, l’inverse est vrai aussi : les IOPS valent environ un divisé par la latence, et 1 / 48 µs donne près de 20 800 opérations. Si les trois chiffres d’un rapport ne concordent pas, le test est mal configuré.
Profondeur de file : pourquoi la publicité cite QD32 alors qu’un site vit en QD1
La profondeur de file (queue depth, QD) est le nombre de requêtes qui attendent le disque en même temps. En QD32, le même disque de VM a fourni 129 189 IOPS, 6,3 fois plus qu’en QD1, mais chaque requête a attendu 247 µs en moyenne au lieu de 48. Un processus PHP exécute ses requêtes SQL l’une après l’autre : le chargement d’une page ressemble donc plutôt à du QD1. Les files profondes apparaissent quand des dizaines de visiteurs et de tâches de fond sollicitent le disque en même temps, et c’est là que les bons disques se détachent des faibles.
Pourquoi WordPress et MySQL dépendent du 4K et de fsync, pas des Mo/s
InnoDB stocke les données dans des pages de 16 Ko et les lit à des endroits dispersés du fichier : c’est un accès aléatoire. Tant que la base tient dans le buffer pool (innodb_buffer_pool_size), les lectures sont servies depuis la RAM et le disque est à peine sollicité : lors de notre test sysbench, 92 Mo de tables tenaient dans un buffer pool de 256 Mo. Le disque devient le goulot d’étranglement quand la base dépasse le buffer pool, ou quand le site écrit.
Les écritures, c’est autre chose. Par défaut (innodb_flush_log_at_trx_commit=1), chaque transaction validée force l’écriture du journal sur le disque avec fsync, et la requête attend que le disque confirme. WordPress fonctionne en autocommit : chaque INSERT ou UPDATE est donc une transaction à part. Nous avons mesuré une action courante dans l’administration (publier un article avec deux étiquettes et un champ méta, puis le mettre à jour) : 95 à 102 requêtes SQL et 16 à 18 appels fsync par enregistrement. Paniers, commandes, sessions, transients et journaux d’extensions se comportent de la même façon.
Un site adossé à une base de données dépend donc de deux chiffres : la latence des lectures aléatoires 4K en QD1 et la latence d’écriture avec fsync. Les Mo/s séquentiels comptent pour les sauvegardes, les archives et les gros fichiers multimédias.
Résultats fio : disque de VM cloud contre tmpfs
Quatre profils, un fichier de 1 Go, 15 secondes chacun, direct=1 pour contourner le cache de pages du noyau :
fio --name=rr1  --filename=./fio.dat --size=1G --runtime=15 --time_based --direct=1 \
    --rw=randread --bs=4k --ioengine=libaio --iodepth=1
fio --name=rr32 ... --rw=randread --bs=4k --ioengine=libaio --iodepth=32
fio --name=wfs  ... --rw=randwrite --bs=4k --ioengine=sync --fsync=1
fio --name=seq  ... --rw=read --bs=1M --ioengine=libaio --iodepth=8
| Profil | Disque VM : IOPS | Disque VM : Mio/s | Disque VM : latence, moyenne / p99 | tmpfs : IOPS |
|---|---|---|---|---|
| Lecture aléatoire 4K, QD1 | 20 578 | 80,4 | 48 / 101 µs | 552 115 |
| Lecture aléatoire 4K, QD32 | 129 189 | 504,6 | 247 / 692 µs | 546 572 |
| Écriture aléatoire 4K + fsync après chaque bloc | 9 105 | 35,6 | écriture 40 µs + fsync 69 µs (fsync p99 169 µs) | 499 993 |
| Lecture séquentielle 1M, QD8 | 2 218 | 2 218 | 3,6 ms | 5 729 |
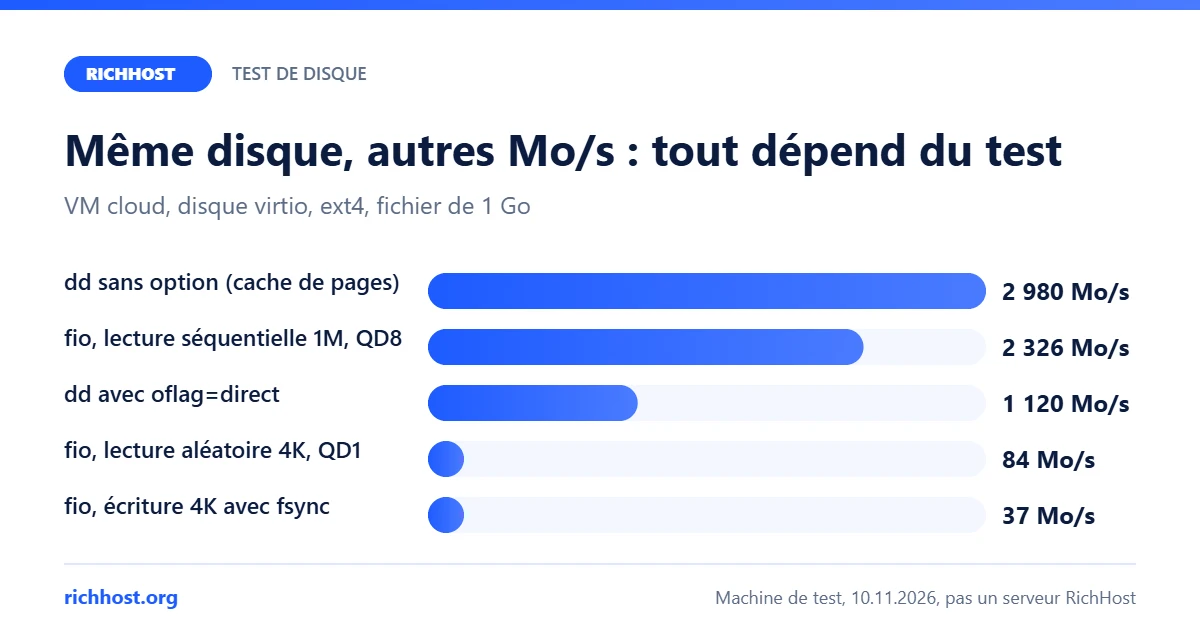
La charge moyenne est passée de 0,12 à 0,80 pendant les essais sur disque et est restée entre 0,68 et 1,00 sur tmpfs. L’essentiel tient en une ligne : le même disque donne 2 218 Mio/s en séquentiel et seulement 35,6 Mio/s quand chaque bloc de 4 Ko doit être confirmé par fsync. Un nouvel essai sur un fichier de 4 Go a même montré une latence plus faible (37 µs), signe d’un cache côté hôte ; une mémoire NAND nue est en général plus lente en lecture 4K. tmpfs montre le plafond sans aucun disque : la latence n’y est que de quelques microsecondes.
Le même écart sur un graphique (Mio/s de fio convertis en Mo/s décimaux, comme les affiche dd) :
Le piège de dd : 3 Go/s qui n’existent pas
dd if=/dev/zero est encore conseillé comme « test de disque ». Voici ce qu’il affiche sur le même disque (charge moyenne 0,47) :
$ dd if=/dev/zero of=dd.test bs=1M count=1024
1073741824 bytes (1.1 GB, 1.0 GiB) copied, 0.360278 s, 3.0 GB/s
$ grep Dirty /proc/meminfo
Dirty:            516116 kB
$ dd if=/dev/zero of=dd.test bs=1M count=1024 conv=fdatasync
1073741824 bytes (1.1 GB, 1.0 GiB) copied, 0.952127 s, 1.1 GB/s
$ dd if=/dev/zero of=dd.test bs=1M count=1024 oflag=direct
1073741824 bytes (1.1 GB, 1.0 GiB) copied, 0.958656 s, 1.1 GB/s
$ dd if=dd.test of=/dev/null bs=1M        # read again
1073741824 bytes (1.1 GB, 1.0 GiB) copied, 0.141227 s, 7.6 GB/s
$ dd if=/dev/zero of=dd.test bs=4k count=5000 oflag=dsync
20480000 bytes (20 MB, 20 MiB) copied, 0.762809 s, 26.8 MB/s
Sans option, dd écrit dans le cache de pages du noyau et se termine avant que les données n’atteignent le disque : juste après la commande, 516 Mo de pages modifiées (dirty) étaient encore en mémoire. Le résultat est gonflé 2,7 fois. Relire le fichier a donné 7,6 Go/s, car il venait de la RAM. Les options honnêtes sont conv=fdatasync ou oflag=direct pour l’écriture et iflag=direct pour la lecture. Même un dd correct ne mesure que l’accès séquentiel. La dernière ligne se rapproche d’une base de données : de petites écritures synchrones ont atteint 26,8 Mo/s. Autre piège : certains stockages compressent ou dédupliquent les zéros de /dev/zero, ce qui embellit encore le chiffre.
fsync en pratique : MariaDB avec innodb_flush_log_at_trx_commit à 1 ou à 2
La valeur 1 (par défaut) écrit le journal sur le disque à chaque validation. La valeur 2 écrit le journal à la validation mais ne le synchronise sur le disque qu’environ une fois par seconde ; selon la documentation de MariaDB, un plantage du système d’exploitation ou une coupure de courant peut faire perdre la dernière seconde de transactions. Nous avons comparé les deux avec sysbench oltp_read_write (4 tables de 100 000 lignes, 20 secondes) et avec 40 enregistrements d’articles dans WordPress :
| Test | flush = 1 | flush = 2 | Charge moyenne |
|---|---|---|---|
| sysbench, 1 thread : transactions/s, latence moyenne | 545 et 575 ; 1,83 et 1,74 ms | 666 et 636 ; 1,50 et 1,57 ms | 0,7 à 2,9 |
| sysbench, 4 threads : transactions/s, p95 | 1 324 ; 5,18 ms | 1 459 ; 5,09 ms | 1,4 à 3,7 |
| appels fsync en 20 s (1 thread) | 11 028 | 161 | |
| WordPress : temps moyen d’enregistrement (2 essais) | 24,5 et 22,0 ms | 17,6 et 20,7 ms | 1,8 à 1,9 |
| WordPress : fsync par enregistrement | 16,5 à 18,1 | 0,4 à 0,5 |
Le nombre d’appels fsync a été divisé par environ 70, mais la vitesse n’a gagné que 10 à 22 %. La raison tient au disque de test : fsync y prend environ 0,07 ms. Sur un disque où fsync prend des millisecondes, le tableau change. Pour un disque dur à 7200 tr/min, Seagate indique une latence moyenne de 4,16 ms : 17 appels fsync par enregistrement ajouteraient donc environ 70 ms ou plus, et un seul thread de base de données plafonnerait à environ 240 validations par seconde (1 / 4,16 ms). Voilà pourquoi, sur un disque lent, WordPress rame dans l’administration et au moment du paiement alors que la page d’accueil en cache se charge toujours vite.
La valeur 2 est raisonnable là où perdre une seconde de données lors d’un plantage du serveur est acceptable : copies de préproduction, imports, blog sans commandes. Pour une boutique qui encaisse des paiements, gardez 1 et prenez un disque plus rapide. Sur un hébergement mutualisé, seul l’hébergeur peut modifier ce réglage, et c’est normal : il s’applique à tous les sites du serveur.
NVMe, SSD SATA et disque dur : ce que disent les fiches techniques
Nous avons choisi un modèle courant de chaque type. Ce sont des valeurs « jusqu’à » tirées des fiches techniques des fabricants (vérifiées le 10.11.2026), mesurées sur leurs propres systèmes de test :
| Disque | Lecture séquentielle | Lecture aléatoire, QD1 | Lecture aléatoire, file profonde | Latence dans la fiche |
|---|---|---|---|---|
| Samsung 990 PRO (NVMe, PCIe 4.0) | 7 450 Mo/s | 22 000 IOPS | 1 200 000 à 1 400 000 IOPS (QD32, 16 threads) | non indiquée |
| Samsung 870 EVO (SSD SATA) | 560 Mo/s | 13 000 IOPS (4 Ko) | 98 000 IOPS (QD32) | non indiquée |
| Seagate Exos X16 (disque dur, 7200 tr/min) | 261 Mo/s | non indiquée | 170 IOPS (4K, QD16) | 4,16 ms en moyenne |
Le plus intéressant est le QD1 : le NVMe bat le SSD SATA d’un facteur 13 en lecture séquentielle, mais seulement de 1,7 fois sur des lectures aléatoires isolées. L’avantage du NVMe apparaît avec une file profonde, quand un site traite beaucoup de requêtes à la fois. Le disque dur perd face aux deux de plusieurs ordres de grandeur en accès aléatoire : 170 opérations par seconde, même avec une file de 16. Les fiches grand public n’indiquent pas la latence de fsync, qui dépend beaucoup de la présence d’une protection contre les coupures de courant permettant au disque de confirmer les écritures depuis son propre cache. Testez donc fsync vous-même.
Comment mesurer le disque de votre propre VPS
Installez les outils (apt install fio ioping), placez-vous dans un répertoire de la partition qui contient la base de données (en général /var/lib/mysql) et lancez des tests courts. Il vous faut au moins 2 Go d’espace libre :
# latency: 20 requests of 4 KiB, bypassing the cache
ioping -c 20 -D .
# synchronous write latency
ioping -c 20 -W -Y .
# key for databases: 4K random read at QD1
fio --name=rr1 --filename=./fio.dat --size=1G --runtime=15 --time_based \
    --direct=1 --rw=randread --bs=4k --ioengine=libaio --iodepth=1
# 4K writes with fsync after every block
fio --name=wfs --filename=./fio.dat --size=1G --runtime=15 --time_based \
    --direct=1 --rw=randwrite --bs=4k --ioengine=sync --fsync=1
rm -f ./fio.dat
Dans le rapport de fio, regardez IOPS=, clat (moyenne et centiles 99,00 et 99,90) et, pour les écritures, le bloc fsync/fdatasync/sync_file_range. Sur notre machine, ioping a montré une latence moyenne de lecture de 123 à 210 µs et une latence d’écriture O_SYNC de 611 à 627 µs, avec un pic à 54 ms. Les chiffres d’ioping sont plus élevés que ceux de fio, car il n’envoie que quelques requêtes par seconde à un disque autrement inactif ; ne comparez que des résultats obtenus avec le même outil.
Erreurs de mesure courantes
- dd sans direct ni fdatasync : vous mesurez la RAM.
- Tester dans /tmp : sur beaucoup de systèmes, c’est un tmpfs, donc encore la RAM.
- Comparer du QD32 sur un disque avec du QD1 sur un autre : les seuls réglages du test peuvent créer un écart de plusieurs fois.
- Un seul essai court : sur du matériel partagé, les voisins et les limites modifient le résultat. Lancez le test 3 fois à des heures différentes et vérifiez le p99, pas seulement la moyenne.
- libaio sans
direct=1: d’après la documentation de fio, Linux ne met en file que les E/S non tamponnées, donciodepth=32ne s’applique pas vraiment. - Un fichier de test plus petit que le cache de l’hôte : dans le cloud, l’hyperviseur peut mettre le disque en cache, et le résultat dépassera ce que le disque sait faire.
Un hébergement mutualisé n’a en général pas fio, et une charge soutenue sur un disque partagé peut déclencher les limites cachées de l’hébergement mutualisé. Mieux vaut y mesurer ce que le site obtient : le temps jusqu’au premier octet (TTFB) des pages hors cache et la durée d’enregistrement d’un article dans l’administration. Pour vérifier le comportement sous charge, faites un test de charge du site prudent.
Si X, alors Y
| Si | Alors |
|---|---|
| La lecture aléatoire 4K en QD1 dépasse 1 ms en moyenne | Le disque est un stockage réseau ou un disque dur. Pour la base de données, cherchez du NVMe ou du SSD local ; en attendant, agrandissez le buffer pool InnoDB pour que les lectures viennent de la RAM |
| L’écriture 4K avec fsync donne moins de 1 000 IOPS | Attendez-vous à une administration et à un tunnel de commande lents. Réduisez le nombre d’écritures (cache d’objets, nettoyage des options autoload et des transients) ; pour des copies non critiques, envisagez flush 2 |
| dd affiche des gigaoctets par seconde, mais le site est lent | Refaites le test avec oflag=direct et lancez les tests fio en 4K : la vitesse séquentielle n’explique rien ici |
| La latence moyenne est correcte, mais le p99 grimpe à des dizaines de millisecondes | Probablement des voisins bruyants ou un plafond d’IOPS dans votre offre. Répétez à d’autres moments et interrogez l’hébergeur sur les limites |
| La page d’accueil est rapide ; seuls la recherche, les filtres et les rapports sont lents | Ce sont des requêtes sans index, pas le disque : commencez par l’optimisation de la base de données |
| Le serveur écrit beaucoup dans le swap quand il ralentit | C’est un problème de mémoire : le disque est occupé par le swap au lieu de la base. Lisez notre article sur le swap et l’OOM killer |
| Il reste de l’espace disque, mais impossible de créer des fichiers | Vérifiez la limite d’inodes, pas la vitesse |
| Vous êtes sur un hébergement mutualisé et ne pouvez pas lancer fio | Mesurez le TTFB des pages hors cache et le temps d’enregistrement dans l’administration ; au moment de choisir une offre, demandez quels disques elle utilise |
Avec les offres d’hébergement RichHost, les sites tournent sur des disques NVMe. Nous ne donnons pas ici de chiffres d’IOPS pour ces offres : les mesures de cet article viennent d’une VM cloud, pas de nos serveurs.
FAQ
Combien d’IOPS faut-il pour un site WordPress ?
Il n’existe pas de chiffre universel. Si la base tient dans le buffer pool et que les pages sont en cache, les lectures n’atteignent presque pas le disque. La latence compte davantage : sur notre machine, un seul enregistrement d’article a provoqué 16 à 18 appels fsync. Avec un fsync qui se compte en millisecondes, l’administration ralentit nettement, même sur un petit site.
Peut-on se fier à un test dd ?
Seulement avec oflag=direct ou conv=fdatasync, et seulement comme estimation de l’écriture séquentielle. Sans ces options, dd affichait 3,0 Go/s sur notre machine au lieu de 1,1 Go/s réels.
NVMe ou SSD SATA : un petit site verra-t-il la différence ?
D’après les fiches de Samsung, les lectures aléatoires isolées diffèrent de 22 000 contre 13 000 IOPS, soit moins du double. Le NVMe l’emporte sous charge, quand de nombreuses requêtes s’exécutent en même temps ; un disque dur ne convient pas à une base de données.
innodb_flush_log_at_trx_commit=2 est-il sûr ?
Un plantage de MariaDB seul ne fait pas perdre de données, mais un plantage du système d’exploitation ou une coupure de courant peut coûter la dernière seconde de transactions. Pour une boutique qui encaisse des paiements, gardez 1.
Pourquoi ioping et fio donnent-ils des latences différentes ?
ioping envoie quelques requêtes par seconde à un disque inactif, tandis que fio l’occupe en permanence. Comparez les disques avec le même outil et les mêmes paramètres.


