


IOPS is het aantal lees- en schrijfbewerkingen dat een schijf per seconde afrondt, latentie is hoe lang één bewerking wacht en doorvoer is het aantal megabytes per seconde. Bij IOPS en latentie draait het voor WordPress en MySQL vooral om de latentie van willekeurige leesacties van 4 KB en de duur van fsync, want elke databasequery wacht daarop; de geadverteerde gigabytes per seconde tellen alleen bij grote bestanden. Hieronder staan echte metingen op een virtuele machine in de cloud: fio, ioping, de valkuil van dd en wat fsync doet met MariaDB en met het opslaan van een bericht in WordPress.
Zo hebben we getest
Op 10 november 2026 op een virtuele machine in de cloud, niet op een server van RichHost: Firecracker-gast, Ubuntu 24.04.5, 2 vCPU, 7,8 GB RAM, een virtio-schijf van 256 GB met ext4. Welk fysiek medium achter die schijf zit, is onbekend en de host kan data cachen, dus deze cijfers zijn niet over te zetten naar andere hosting. Een tmpfs (een bestandssysteem in RAM) diende als plafond. Tools: fio 3.36, ioping 1.3, dd, sysbench 1.0.20, MariaDB 10.11.14, WordPress 6.4.3. Elke run duurde 15 tot 20 seconden; de machine is gedeeld, daarom hebben we de load average bijgehouden (0,1 tot 3,7). De schijfspecificaties komen uit officiële datasheets van Samsung en Seagate; de documentatie van fio en MariaDB is gecontroleerd op 10.11.2026.
Drie getallen en hoe ze samenhangen
IOPS (input/output operations per second) is een aantal bewerkingen. Op zich zegt het niets zonder de blokgrootte, het toegangspatroon (sequentieel of willekeurig) en de wachtrijdiepte.
Latentie is de tijd van verzoek tot antwoord voor één bewerking, in microseconden of milliseconden. Het gemiddelde is niet genoeg: kijk naar het 99e percentiel, want de traagste 1 % van de verzoeken ervaren gebruikers als haperingen.
Doorvoer wordt gemeten in megabytes per seconde en is gelijk aan IOPS maal blokgrootte. Op onze testmachine haalde fio 20.578 willekeurige leesacties van 4 KB per seconde, oftewel 80,4 MiB/s. Bij wachtrijdiepte 1 geldt ook het omgekeerde: IOPS is ongeveer één gedeeld door de latentie, en 1 / 48 µs geeft zo’n 20.800 bewerkingen. Kloppen de drie getallen in een rapport niet met elkaar, dan is de test verkeerd ingesteld.
Wachtrijdiepte: waarom reclame QD32 noemt terwijl een website op QD1 leeft
De wachtrijdiepte (queue depth, QD) is het aantal verzoeken dat tegelijk op de schijf wacht. Bij QD32 leverde dezelfde VM-schijf 129.189 IOPS, 6,3 keer zoveel als bij QD1, maar elk verzoek wachtte gemiddeld 247 µs in plaats van 48. Eén PHP-proces voert zijn databasequery’s na elkaar uit, dus het laden van één pagina lijkt meer op QD1. Diepe wachtrijen ontstaan als tientallen bezoekers en achtergrondtaken tegelijk de schijf gebruiken, en precies daar lopen goede schijven uit op zwakke.
Waarom WordPress en MySQL om 4K en fsync geven, niet om MB/s
InnoDB slaat data op in pagina’s van 16 KB en leest ze van verspreide plekken in het bestand, dus met willekeurige toegang. Zolang de database in de buffer pool past (innodb_buffer_pool_size), komen leesacties uit het RAM en wordt de schijf nauwelijks aangeraakt: in onze sysbench-run paste 92 MB aan tabellen in een buffer pool van 256 MB. De schijf wordt de bottleneck als de database groter wordt dan de buffer pool, of als de site schrijft.
Bij schrijven ligt het anders. Standaard (innodb_flush_log_at_trx_commit=1) dwingt elke bevestigde transactie de log met fsync naar de schijf, en de query wacht tot de schijf het bevestigt. WordPress werkt in autocommit-modus, dus elke INSERT of UPDATE is een eigen transactie. We hebben een typische actie in het beheer gemeten (een bericht met twee tags en een metaveld publiceren en daarna bijwerken): 95 tot 102 SQL-query’s en 16 tot 18 fsync-aanroepen per keer opslaan. Winkelwagens, bestellingen, sessies, transients en pluginlogs gedragen zich net zo.
Een site met een database hangt dus af van twee getallen: de latentie van willekeurig lezen in 4K bij QD1 en de schrijflatentie met fsync. Sequentiële MB/s tellen bij back-ups, archieven en grote mediabestanden.
fio-resultaten: schijf van de cloud-VM tegenover tmpfs
Vier profielen, een bestand van 1 GB, elk 15 seconden, direct=1 om de page cache van de kernel te omzeilen:
fio --name=rr1  --filename=./fio.dat --size=1G --runtime=15 --time_based --direct=1 \
    --rw=randread --bs=4k --ioengine=libaio --iodepth=1
fio --name=rr32 ... --rw=randread --bs=4k --ioengine=libaio --iodepth=32
fio --name=wfs  ... --rw=randwrite --bs=4k --ioengine=sync --fsync=1
fio --name=seq  ... --rw=read --bs=1M --ioengine=libaio --iodepth=8
| Profiel | VM-schijf: IOPS | VM-schijf: MiB/s | VM-schijf: latentie, gemiddeld / p99 | tmpfs: IOPS |
|---|---|---|---|---|
| Willekeurig lezen 4K, QD1 | 20.578 | 80,4 | 48 / 101 µs | 552.115 |
| Willekeurig lezen 4K, QD32 | 129.189 | 504,6 | 247 / 692 µs | 546.572 |
| Willekeurig schrijven 4K + fsync na elk blok | 9.105 | 35,6 | schrijven 40 µs + fsync 69 µs (fsync p99 169 µs) | 499.993 |
| Sequentieel lezen 1M, QD8 | 2.218 | 2.218 | 3,6 ms | 5.729 |
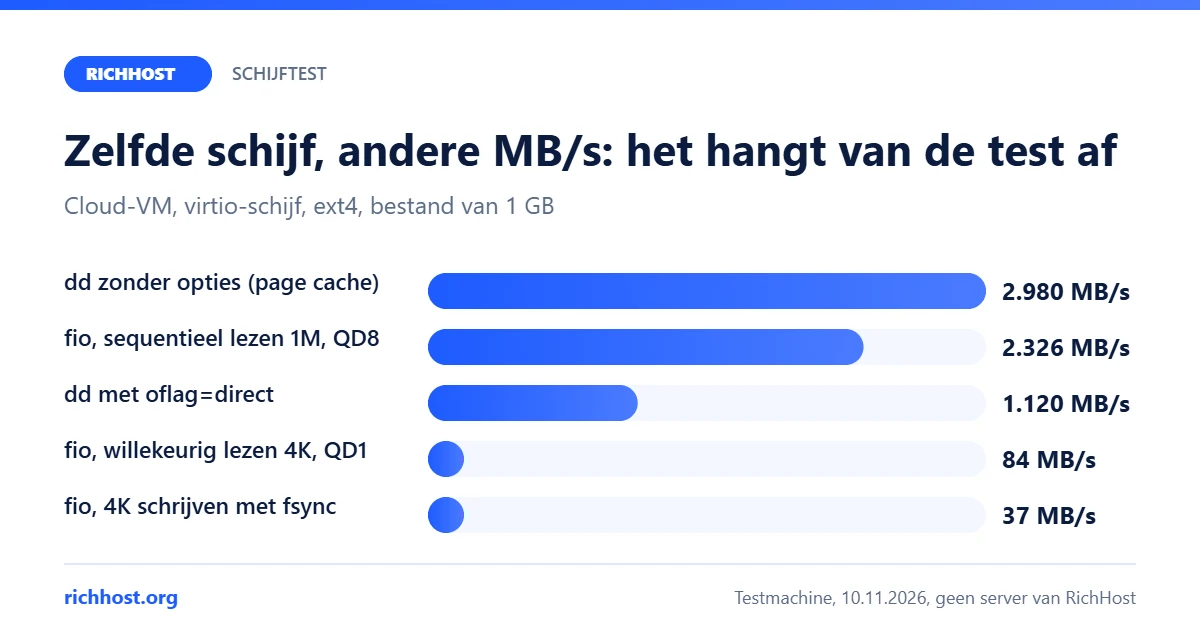
De load average steeg tijdens de schijfruns van 0,12 naar 0,80 en lag op tmpfs tussen 0,68 en 1,00. De kern past in één zin: dezelfde schijf haalt sequentieel 2.218 MiB/s en maar 35,6 MiB/s als elk blok van 4 KB met fsync bevestigd moet worden. Een herhaling met een bestand van 4 GB liet zelfs een lagere latentie zien (37 µs), een teken van caching aan de kant van de host; kale NAND is bij 4K-leesacties meestal trager. tmpfs toont het plafond zonder schijf: de latentie is daar enkele microseconden.
Hetzelfde verschil in één grafiek (MiB/s van fio omgerekend naar decimale MB/s, zoals dd ze weergeeft):
De dd-valkuil: 3 GB/s die er niet zijn
dd if=/dev/zero wordt nog steeds aangeraden als “schijftest”. Dit is wat het laat zien op dezelfde schijf (load average 0,47):
$ dd if=/dev/zero of=dd.test bs=1M count=1024
1073741824 bytes (1.1 GB, 1.0 GiB) copied, 0.360278 s, 3.0 GB/s
$ grep Dirty /proc/meminfo
Dirty:            516116 kB
$ dd if=/dev/zero of=dd.test bs=1M count=1024 conv=fdatasync
1073741824 bytes (1.1 GB, 1.0 GiB) copied, 0.952127 s, 1.1 GB/s
$ dd if=/dev/zero of=dd.test bs=1M count=1024 oflag=direct
1073741824 bytes (1.1 GB, 1.0 GiB) copied, 0.958656 s, 1.1 GB/s
$ dd if=dd.test of=/dev/null bs=1M        # read again
1073741824 bytes (1.1 GB, 1.0 GiB) copied, 0.141227 s, 7.6 GB/s
$ dd if=/dev/zero of=dd.test bs=4k count=5000 oflag=dsync
20480000 bytes (20 MB, 20 MiB) copied, 0.762809 s, 26.8 MB/s
Zonder opties schrijft dd naar de page cache van de kernel en is het klaar voordat de data de schijf bereikt: direct na het commando stond er nog 516 MB aan dirty pages in het geheugen. Het resultaat is 2,7 keer te hoog. Het bestand opnieuw lezen gaf 7,6 GB/s, omdat het uit het RAM kwam. Eerlijke opties zijn conv=fdatasync of oflag=direct bij schrijven en iflag=direct bij lezen. Zelfs een correcte dd meet alleen sequentiële toegang. De laatste regel komt dichter bij een database: kleine synchrone schrijfacties haalden 26,8 MB/s. Nog een valkuil: sommige opslag comprimeert of dedupliceert de nullen uit /dev/zero, waardoor het getal nog mooier lijkt.
fsync in de praktijk: MariaDB met innodb_flush_log_at_trx_commit op 1 of 2
Waarde 1 (standaard) schrijft de log bij elke commit naar de schijf. Waarde 2 schrijft de log bij de commit, maar synchroniseert hem maar ongeveer één keer per seconde naar de schijf; volgens de documentatie van MariaDB kan een crash van het besturingssysteem of een stroomstoring de transacties van de laatste seconde kosten. We hebben beide vergeleken met sysbench oltp_read_write (4 tabellen van 100.000 rijen, 20 seconden) en met 40 keer een bericht opslaan in WordPress:
| Test | flush = 1 | flush = 2 | Load average |
|---|---|---|---|
| sysbench, 1 thread: transacties/s, gemiddelde latentie | 545 en 575; 1,83 en 1,74 ms | 666 en 636; 1,50 en 1,57 ms | 0,7 tot 2,9 |
| sysbench, 4 threads: transacties/s, p95 | 1.324; 5,18 ms | 1.459; 5,09 ms | 1,4 tot 3,7 |
| fsync-aanroepen in 20 s (1 thread) | 11.028 | 161 | |
| WordPress: gemiddelde opslagtijd (2 runs) | 24,5 en 22,0 ms | 17,6 en 20,7 ms | 1,8 tot 1,9 |
| WordPress: fsync per keer opslaan | 16,5 tot 18,1 | 0,4 tot 0,5 |
Het aantal fsync-aanroepen daalde ongeveer 70 keer, maar de snelheid ging maar 10 tot 22 % omhoog. De reden is de testschijf: fsync duurt daar zo’n 0,07 ms. Op een schijf waar fsync milliseconden kost, verandert het beeld. Voor een harde schijf van 7200 rpm noemt Seagate een gemiddelde latentie van 4,16 ms, dus 17 fsync-aanroepen per keer opslaan zouden ongeveer 70 ms of meer toevoegen, en één databasethread zou op hooguit zo’n 240 commits per seconde uitkomen (1 / 4,16 ms). Daarom is WordPress op een trage schijf stroperig in het beheer en bij het afrekenen, terwijl de gecachte homepage nog steeds snel laadt.
Waarde 2 is redelijk waar het verlies van een seconde data bij een servercrash acceptabel is: stagingkopieën, imports, een blog zonder bestellingen. Voor een webshop die betalingen ontvangt, houd je 1 aan en kies je een snellere schijf. Op shared hosting kan alleen de provider deze instelling wijzigen, en terecht: ze geldt voor alle sites op de server.
NVMe, SATA-SSD en HDD: wat de datasheets zeggen
We kozen van elk type een gangbaar model. Het zijn “tot”-waarden uit de datasheets van de fabrikanten (gecontroleerd op 10.11.2026), gemeten op hun eigen testsystemen:
| Schijf | Sequentieel lezen | Willekeurig lezen, QD1 | Willekeurig lezen, diepe wachtrij | Latentie in de specificatie |
|---|---|---|---|---|
| Samsung 990 PRO (NVMe, PCIe 4.0) | 7.450 MB/s | 22.000 IOPS | 1.200.000 tot 1.400.000 IOPS (QD32, 16 threads) | niet vermeld |
| Samsung 870 EVO (SATA-SSD) | 560 MB/s | 13.000 IOPS (4 KB) | 98.000 IOPS (QD32) | niet vermeld |
| Seagate Exos X16 (HDD, 7200 rpm) | 261 MB/s | niet vermeld | 170 IOPS (4K, QD16) | gemiddeld 4,16 ms |
Het interessante zit bij QD1: NVMe verslaat de SATA-SSD 13 keer bij sequentieel lezen, maar slechts 1,7 keer bij losse willekeurige leesacties. Het voordeel van NVMe blijkt bij een diepe wachtrij, als een site veel verzoeken tegelijk afhandelt. De HDD verliest bij willekeurige toegang van beide met ordes van grootte: 170 bewerkingen per seconde, zelfs bij wachtrijdiepte 16. Datasheets voor consumenten vermelden geen fsync-latentie, en die hangt sterk af van de vraag of de schijf bescherming tegen stroomuitval heeft waarmee hij schrijfacties vanuit zijn eigen cache mag bevestigen. Test fsync dus zelf.
Zo meet je de schijf op je eigen VPS
Installeer de tools (apt install fio ioping), ga naar een map op de partitie waar de database staat (meestal /var/lib/mysql) en draai korte tests. Je hebt minstens 2 GB vrije ruimte nodig:
# latency: 20 requests of 4 KiB, bypassing the cache
ioping -c 20 -D .
# synchronous write latency
ioping -c 20 -W -Y .
# key for databases: 4K random read at QD1
fio --name=rr1 --filename=./fio.dat --size=1G --runtime=15 --time_based \
    --direct=1 --rw=randread --bs=4k --ioengine=libaio --iodepth=1
# 4K writes with fsync after every block
fio --name=wfs --filename=./fio.dat --size=1G --runtime=15 --time_based \
    --direct=1 --rw=randwrite --bs=4k --ioengine=sync --fsync=1
rm -f ./fio.dat
Kijk in het fio-rapport naar IOPS=, clat (het gemiddelde en het 99,00e en 99,90e percentiel) en bij schrijven naar het blok fsync/fdatasync/sync_file_range. Op onze machine liet ioping een gemiddelde leeslatentie van 123 tot 210 µs zien en een O_SYNC-schrijflatentie van 611 tot 627 µs, met één piek van 54 ms. De cijfers van ioping liggen hoger dan die van fio, omdat het maar een paar verzoeken per seconde stuurt naar een verder inactieve schijf; vergelijk alleen resultaten van dezelfde tool.
Veelgemaakte meetfouten
- dd zonder direct of fdatasync: je meet het RAM.
- Testen in /tmp: op veel systemen is dat tmpfs, dus weer RAM.
- QD32 op de ene schijf vergelijken met QD1 op een andere: alleen de testinstellingen kunnen al een verschil van meerdere keren opleveren.
- Eén korte run: op gedeelde hardware veranderen buren en limieten het resultaat. Draai de test 3 keer op verschillende tijden en kijk naar p99, niet alleen naar het gemiddelde.
- libaio zonder
direct=1: volgens de documentatie van fio zet Linux verzoeken alleen bij ongebufferde I/O in een wachtrij, dusiodepth=32werkt dan niet echt. - Een testbestand dat kleiner is dan de cache van de host: in de cloud kan de hypervisor de schijf cachen, en dan is het resultaat beter dan wat de schijf kan.
Op shared hosting is fio er meestal niet, en aanhoudende belasting op een gedeelde schijf kan verborgen hosting limieten raken. Meet daar liever wat de site krijgt: de time to first byte (TTFB) van niet-gecachte pagina’s en hoe lang het opslaan van een bericht in het beheer duurt. Om het gedrag onder belasting te controleren, doe je voorzichtig een loadtest van je website.
Als X, doe dan Y
| Als | Doe |
|---|---|
| Willekeurig lezen in 4K bij QD1 duurt gemiddeld meer dan 1 ms | De schijf is netwerkopslag of een HDD. Zoek voor de database lokale NVMe of SSD; vergroot in de tussentijd de InnoDB buffer pool, zodat leesacties uit het RAM komen |
| 4K schrijven met fsync geeft minder dan 1.000 IOPS | Reken op een traag beheer en een trage checkout. Beperk het aantal schrijfacties (object cache, opschonen van autoload-opties en transients); overweeg flush 2 voor niet-kritieke kopieën |
| dd toont gigabytes per seconde, maar de site is traag | Herhaal de test met oflag=direct en draai de fio-tests in 4K: sequentiële snelheid verklaart hier niets |
| De gemiddelde latentie is prima, maar p99 springt naar tientallen milliseconden | Waarschijnlijk luidruchtige buren of een IOPS-limiet in je pakket. Herhaal op andere tijden en vraag de provider naar limieten |
| De homepage is snel; alleen zoeken, filters en rapporten zijn traag | Dat zijn query’s zonder indexen, niet de schijf: begin met database optimaliseren |
| De server schrijft veel naar swap terwijl hij traag is | Het is een geheugenprobleem: de schijf is bezig met swap in plaats van met de database. Lees meer over swap en de OOM killer |
| Er is schijfruimte vrij, maar er kunnen geen bestanden worden aangemaakt | Controleer de inode-limiet, niet de snelheid |
| Je zit op shared hosting en kunt fio niet draaien | Meet de TTFB van niet-gecachte pagina’s en de opslagtijd in het beheer; vraag bij het kiezen van een pakket welke schijven het gebruikt |
In de hostingpakketten van RichHost draaien sites op NVMe-schijven. IOPS-waarden noemen we daarvoor hier niet: de metingen in dit artikel komen van een cloud-VM, niet van onze servers.
Veelgestelde vragen
Hoeveel IOPS heeft een WordPress-site nodig?
Er is geen universeel getal. Past de database in de buffer pool en zijn de pagina’s gecacht, dan bereiken leesacties de schijf nauwelijks. Latentie is belangrijker: op onze machine leidde één keer een bericht opslaan tot 16 tot 18 fsync-aanroepen, dus als fsync milliseconden duurt, wordt het beheer merkbaar trager, zelfs bij een kleine site.
Kan ik een dd-test vertrouwen?
Alleen met oflag=direct of conv=fdatasync, en alleen als schatting van sequentieel schrijven. Zonder die opties toonde dd op onze machine 3,0 GB/s in plaats van de echte 1,1 GB/s.
NVMe of SATA-SSD: merkt een kleine site het verschil?
Volgens de datasheets van Samsung verschillen losse willekeurige leesacties met 22.000 tegenover 13.000 IOPS, minder dan een factor twee. NVMe wint onder belasting, als veel verzoeken tegelijk lopen; een HDD is niet geschikt voor een database.
Is innodb_flush_log_at_trx_commit=2 veilig?
Een crash van alleen MariaDB kost geen data, maar een crash van het besturingssysteem of een stroomstoring kan de transacties van de laatste seconde kosten. Voor een webshop die betalingen ontvangt, houd je 1 aan.
Waarom geven ioping en fio een andere latentie?
ioping stuurt een paar verzoeken per seconde naar een inactieve schijf, terwijl fio hem continu bezighoudt. Vergelijk schijven met dezelfde tool en dezelfde parameters.


