

SLA z gwarancją 99,9% uptime dopuszcza 43 minuty 12 sekund przestoju w miesiącu 30-dniowym i 8 godzin 45 minut w roku. Przy 99,95% ten limit spada o połowę (21 min 36 s), a przy 99,99% zostaje tylko 4 min 19 s miesięcznie. Ta liczba nie obiecuje, że strona będzie działać: określa, kiedy dostawca zwróci część rachunku. We wszystkich sześciu SLA, które przeczytaliśmy, rekompensata to kredyt na przyszłe faktury, liczony jako procent ceny samej usługi, i tylko po złożeniu wniosku, zwykle w ciągu 14-60 dni.
Jak sprawdzaliśmy
10 listopada 2026 roku przeczytaliśmy aktualne publiczne SLA Hetzner Cloud, OVHcloud US (VPS), DigitalOcean (Droplets), AWS Lightsail, Google Compute Engine oraz dostawcy hostingu współdzielonego hosting.com; linki i daty wersji są pod tabelą. Limit przestoju i kwoty kredytów policzyliśmy skryptami pokazanymi niżej. Monitoring przetestowaliśmy na stanowisku testowym: kontener Ubuntu 24.04.5 z własną przestrzenią nazw sieci, minimalny serwer WWW w Pythonie 3.13, curl 8.5.0 i trzy skrypty sprawdzające co 5, 60 i 300 sekund przez 70 minut, podczas gdy 10 razy zatrzymywaliśmy serwer. To wyniki ze stanowiska testowego, a nie pomiary serwerów RichHost.
Ile przestoju dopuszcza każdy poziom uptime
Procenty w SLA prawie zawsze liczy się dla miesiąca kalendarzowego, więc dopuszczalny przestój zależy od długości miesiąca. Policzyliśmy go małym skryptem:
#!/usr/bin/env python3
"""Downtime budget for an uptime percentage: per day, week, 30-day month, 31-day month, 365-day year."""
import sys
def fmt(sec):
    sec = round(sec)
    d, r = divmod(sec, 86400); h, r = divmod(r, 3600); m, s = divmod(r, 60)
    out = []
    if d: out.append(f"{d}d")
    if h: out.append(f"{h}h")
    if m: out.append(f"{m}m")
    if s or not out: out.append(f"{s}s")
    return " ".join(out)
periods = [("day", 86400), ("week", 7*86400), ("month30", 30*86400), ("month31", 31*86400), ("year365", 365*86400)]
levels = [float(x) for x in sys.argv[1:]] or [99.0, 99.5, 99.9, 99.95, 99.99, 99.999]
print("uptime%  " + "  ".join(f"{p:>12}" for p, _ in periods))
for u in levels:
    print(f"{u:<8} " + "  ".join(f"{fmt(t*(100-u)/100):>12}" for _, t in periods))
$ python3 budget.py
uptime%           day          week       month30       month31       year365
99.0          14m 24s    1h 40m 48s        7h 12m    7h 26m 24s    3d 15h 36m
99.5           7m 12s       50m 24s        3h 36m    3h 43m 12s    1d 19h 48m
99.9           1m 26s        10m 5s       43m 12s       44m 38s    8h 45m 36s
99.95             43s         5m 2s       21m 36s       22m 19s    4h 22m 48s
99.99              9s            1m        4m 19s        4m 28s       52m 34s
99.999             1s            6s           26s           27s        5m 15s
| Uptime | Na dzień | Na miesiąc (30 dni) | Na miesiąc (31 dni) | Na rok |
|---|---|---|---|---|
| 99% | 14 min 24 s | 7 h 12 min | 7 h 26 min | 3 dni 15 h 36 min |
| 99,5% | 7 min 12 s | 3 h 36 min | 3 h 43 min | 1 dzień 19 h 48 min |
| 99,9% | 1 min 26 s | 43 min 12 s | 44 min 38 s | 8 h 45 min 36 s |
| 99,95% | 43 s | 21 min 36 s | 22 min 19 s | 4 h 22 min 48 s |
| 99,99% | 9 s | 4 min 19 s | 4 min 28 s | 52 min 34 s |
| 99,999% | 1 s | 26 s | 27 s | 5 min 15 s |
Jeden szczegół jest ważny: miesięczny limit nie przechodzi na kolejny miesiąc. 40 minut awarii 30. dnia miesiąca i kolejne 40 minut 1. dnia następnego miesiąca nie naruszają SLA na poziomie 99,9%, choć strona nie działała przez 80 minut bez przerwy. W ciągu roku możesz stracić 8 godzin, a dostawca nie będzie Ci nic winien za żaden pojedynczy miesiąc.
Co sześciu znanych dostawców zapisuje w swoich SLA
Wybraliśmy serwery w chmurze i VPS dużych firm oraz jednego dostawcę hostingu współdzielonego, który publikuje warunki rekompensaty. Tabela opiera się na tekstach SLA według stanu na 10 listopada 2026 roku.
| Dostawca i usługa | Cel miesięczny | Co liczy się jako przestój | Co jest wyłączone | Rekompensata | Jak i kiedy zgłosić |
|---|---|---|---|---|---|
| Serwery Hetzner Cloud | 99,9% na serwer | Host lub hypervisor nie działa, brak aktywności instancji w metrykach systemu | Planowane prace serwisowe (ogłoszone co najmniej 24 h wcześniej), ataki DoS i włamania, błędy klienta, sieć poza routerami szkieletowymi Hetznera, migracje na żywo, siła wyższa | Stawka godzinowa serwera za godziny ponad progiem 99,9%, maksymalnie 100% miesięcznej faktury, wyłącznie jako Cloud Credits | Zgłoszenie do supportu z identyfikatorami serwerów w ciągu 14 dni po końcu miesiąca; klient musi wykazać przestój |
| OVHcloud US, VPS | 99,9% | Brak łączności z zewnątrz; czas liczy się od otwarcia zgłoszenia przez klienta; liczy się tylko monitoring OVHcloud | Planowane okna serwisowe, DoS, wirusy i włamania, błędy klienta, nieaktualne oprogramowanie, sieć poza routerem brzegowym, siła wyższa | 10% przy 99,0-99,9%, 30% przy 95-99%, 100% poniżej 95%; maksymalnie 100% | Wniosek w Control Panel w ciągu 60 dni od incydentu |
| DigitalOcean, CPU Droplets | 99,99% na Droplet | Brak łączności przez publiczny lub prywatny adres IP albo brak dostępu do dysku głównego | Planowane prace serwisowe, przestoje wywołane przez klienta, siła wyższa, awarie podmiotów trzecich, kod i konfiguracja klienta; DDoS nie jest wspomniany | 100% opłat za dany Droplet poniżej 99,99%; tekst nie mówi, czy chodzi o cały miesiąc, czy tylko o godziny przestoju | E-mail na success@digitalocean.com w ciągu dwóch cykli rozliczeniowych |
| Instancje AWS Lightsail | 99,99% na poziomie regionu (kilka stref), 99,5% na instancję | Brak łączności z zewnątrz | Czynniki poza kontrolą AWS, działania klienta, oprogramowanie klienta, przekroczenie limitów; SLA regionalne pomija awarie pojedynczej instancji | 10%, 30% lub 100% zależnie od spadku; wypłacany tylko, gdy kredyt przekracza $1 | Zgłoszenie w Support Center do końca drugiego cyklu rozliczeniowego, z datami, identyfikatorami zasobów i logami |
| Google Compute Engine | 99,99% wiele stref (Premium), 99,9% pojedyncza VM | Utrata łączności z zewnątrz lub dostępu do dysku, liczona od 1 pełnej minuty z rzędu | Czynniki poza kontrolą Google, oprogramowanie klienta lub podmiotów trzecich, nadużycia, limity, funkcje przed GA | Pojedyncza VM: 10% przy 95-99,9%, 25% przy 90-95%, 100% poniżej 90%; maksymalnie 100% | Formularz supportu w ciągu 60 dni, z logami przestoju |
| hosting.com, hosting współdzielony | 99,9% | Nieplanowany przestój strony z winy sieci lub sprzętu dostawcy, potwierdzony przez support | Planowane prace serwisowe, DDoS i inne ataki, sieć między Twoim dostawcą internetu a centrum danych, pamięć podręczna przeglądarki i DNS | 5% opłaty miesięcznej za każdą godzinę ponad 0,1% miesiąca, maksymalnie do wysokości opłaty miesięcznej | Zgłoszenie do supportu; brak terminu |
Źródła (sprawdzone 10 listopada 2026 roku): umowa Hetzner Cloud Server i przykład obliczenia Hetznera (wersja z 16 marca 2026); SLA VPS OVHcloud US (obowiązuje od 7 sierpnia 2025); SLA Droplet DigitalOcean (aktualizacja 3 czerwca 2025); SLA AWS Lightsail (20 maja 2022); SLA Google Compute Engine (14 października 2026); zobowiązanie dotyczące uptime hosting.com (bez daty wersji).
Co zwykle nie liczy się jako przestój
Prawdziwe różnice tkwią w definicjach, nie w liczbach. Pięć rzeczy, na które warto zwrócić uwagę w każdym SLA:
- Co jest mierzone. Hetzner uznaje serwer za dostępny, jeśli host działa, a instancja wykazuje aktywność w metrykach. Google, AWS i DigitalOcean patrzą na łączność z zewnątrz. Jeśli strona zwraca błąd 500, a serwer odpowiada na żądania, w rozumieniu SLA to nie jest przestój.
- Planowane prace serwisowe. Wszyscy, którzy o nich wspominają, je wyłączają. Sprawdź, z jakim wyprzedzeniem dostaniesz informację i czy czas trwania jest ograniczony: Hetzner obiecuje co najmniej 24 godziny wyprzedzenia i nie określa limitu.
- Ataki. Hetzner, OVHcloud i hosting.com wprost wyłączają DoS i DDoS. W Google i AWS atak najpewniej trafi do kategorii „czynniki poza naszą kontrolą”.
- Kiedy zaczyna się liczenie czasu. OVHcloud US liczy przestój od chwili otwarcia zgłoszenia, a nie od początku awarii. Google pomija wszystko, co trwa krócej niż minutę.
- Czyje dane się liczą. OVHcloud opiera się tylko na własnym monitoringu, a Hetzner i AWS oczekują, że to klient udowodni przestój. Bez własnych logów niczego nie udowodnisz.
Ile naprawdę jest wart kredyt
Aby porównać zasady, policzyliśmy kredyt dla hipotetycznej usługi za $20 miesięcznie i jednej awarii w miesiącu 30-dniowym. Uproszczenia: jeden serwer, żadne wyłączenie nie ma zastosowania, a zgłoszenie w OVHcloud jest otwierane od razu.
$ python3 credit.py 180 20
outage 180 min, month uptime 99.583%, plan $20.00/month
  Hetzner Cloud        $  0.06  (  0.3%)
  OVHcloud US VPS      $  2.00  ( 10.0%)
  DigitalOcean         $ 20.00  (100.0%)
  Lightsail instance   $  0.00  (  0.0%)
  GCE single VM        $  2.00  ( 10.0%)
  hosting.com shared   $  2.28  ( 11.4%)
| Dostawca | Awaria 30 min (99,93%) | Awaria 3 h (99,58%) | Awaria 10 h (98,61%) |
|---|---|---|---|
| Hetzner Cloud | $0 | $0,06 | $0,26 |
| OVHcloud US VPS | $0 | $2 | $6 |
| DigitalOcean | do $20 | do $20 | do $20 |
| AWS Lightsail, pojedyncza instancja | $0 | $0 | $6 |
| Google Compute Engine, pojedyncza VM | $0 | $2 | $2 |
| hosting.com | $0 | około $2,30 | około $9,30 |
Wniosek jest prosty: 30-minutowa awaria prawie nigdzie nic nie daje, 3-godzinna zwraca kilka dolarów, a żaden z sześciu dokumentów nie pokrywa przychodu utraconego w tych godzinach. SLA mówi, jak dostawca mierzy niezawodność; stronę naprawdę chroni porządna rutyna kopii zapasowych, monitoring i plan reagowania.
Jak zgłosić roszczenie o kredyt
- Otwórz zgłoszenie, gdy tylko zacznie się awaria, nawet jeśli nie znasz przyczyny: w OVHcloud czas przestoju liczy się od Twojego zgłoszenia.
- Zapisz godzinę początku i końca w UTC z własnego monitoringu, kody odpowiedzi oraz wynik
curlitraceroute. Nasz poradnik o diagnozowaniu problemów z hostingiem w 15 minut pokazuje, jak szybko to zebrać. - Sprawdź stronę statusu dostawcy i zanotuj numer incydentu, jeśli jest.
- Po końcu miesiąca policz rzeczywisty uptime i porównaj go z progiem SLA.
- Złóż wniosek w wymaganym formacie przed terminem: Hetzner 14 dni po końcu miesiąca, OVHcloud i Google 60 dni, AWS i DigitalOcean do końca drugiego cyklu rozliczeniowego. AWS wymaga tematu „Amazon Lightsail SLA Credit Request”, identyfikatorów zasobów i logów.
Jak samodzielnie mierzyć uptime: test interwału sprawdzania
Monitor widzi stronę tylko w chwili sprawdzenia, więc wszystko, co dzieje się między sprawdzeniami, dla niego nie istnieje. Aby zmierzyć, ile to kosztuje, uruchomiliśmy na stanowisku testowym serwer WWW i trzy skrypty sprawdzające co 5, 60 i 300 sekund. Każdy wysyłał żądanie curl z limitem czasu 10 sekund za pomocą tego skryptu:
#!/bin/bash
# checker.sh URL INTERVAL_S LOGFILE T0 END: one curl check every INTERVAL_S seconds
URL=$1; INT=$2; LOG=$3; T0=$4; END=$5
k=0
while :; do
  target=$((T0 + k*INT))
  [ "$target" -ge "$END" ] && break
  d=$(awk -v t="$target" -v n="$(date +%s.%N)" 'BEGIN{d=t-n; if(d>0) printf "%.3f", d; else print 0}')
  sleep "$d"
  res=$(curl --noproxy '*' -s -o /dev/null -m 10 -w '%{http_code} %{time_total}' "$URL")
  echo "$(date +%s.%N | cut -c1-14) $target $res" >> "$LOG"
  k=$((k+1))
done
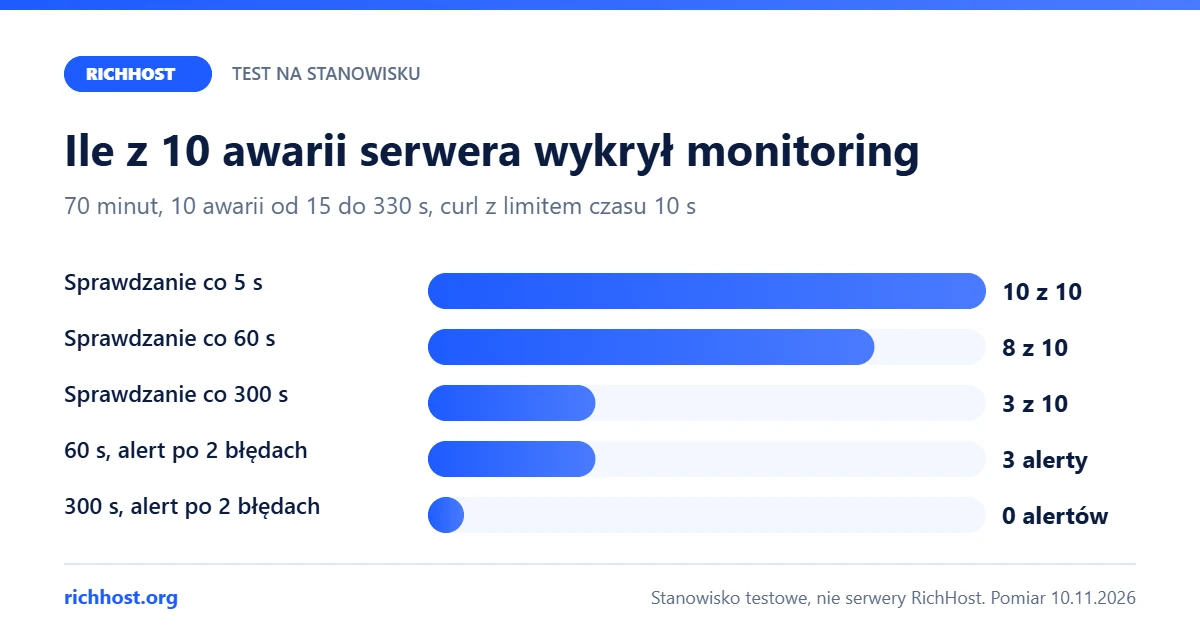
W ciągu 70 minut zatrzymaliśmy serwer 10 razy na 15, 20, 30, 45, 45, 60, 75, 150, 200 i 330 sekund, łącznie 970 sekund. Awarie są celowo częste, żeby jedna godzina dała użyteczne statystyki: uptime w tym oknie wyniósł 76,91%. Podsumowanie analizy logów:
$ python3 analyze.py
window 4200 s, real outages 10, real downtime 970 s, real uptime 76.91%
chk5  : checks 840, failed 202, outages seen 10/10, est downtime 1010 s, est uptime 75.95%, alerts(2 fails) 10
chk60 : checks 70, failed 16, outages seen 8/10, est downtime 960 s, est uptime 77.14%, alerts(2 fails) 3
chk300: checks 14, failed 3, outages seen 3/10, est downtime 900 s, est uptime 78.57%, alerts(2 fails) 0

$ grep -v " 200 " chk300.log
1794327092.019 1794327092 000 0.000075
1794327992.010 1794327992 000 0.000093
1794329192.021 1794329192 000 0.000095
| Wskaźnik | Rzeczywiście | Co 5 s | Co 60 s | Co 300 s |
|---|---|---|---|---|
| Wykryte awarie z 10 | 10 | 10 | 8 | 3 |
| Najkrótsza wykryta awaria | 15 s | 15 s | 15 s | 150 s |
| Szacowany przestój | 970 s | 1010 s | 960 s | 900 s |
| Szacowany uptime | 76,91% | 75,95% | 77,14% | 78,57% |
| Alerty przy „2 nieudanych sprawdzeniach z rzędu” | 10 awarii | 10 | 3 | 0 |
| Średnie opóźnienie do pierwszego wykrycia | - | 1 s | 30 s | 133 s |
Co to oznacza w praktyce:
- Skrypt sprawdzający co 5 minut przeoczył 7 z 10 awarii, w tym te trwające 60 i 75 sekund, i wykrywał tylko awarie od 150 sekund wzwyż. Z regułą „alert po dwóch nieudanych sprawdzeniach” nie wysłał żadnego alertu, choć serwer nie działał przez 330 sekund bez przerwy.
- Skrypt sprawdzający co minutę przeoczył awarie trwające 20 i 30 sekund, a tę 15-sekundową złapał przypadkiem, bo jedno żądanie trafiło akurat w jej środek. Szansa trafienia na awarię krótszą niż interwał równa się jej długości podzielonej przez interwał: dla awarii 30-sekundowej to 50% przy sprawdzaniu co minutę i 10% przy sprawdzaniu co 5 minut.
- Oszacowanie łącznego przestoju było bliskie rzeczywistości dla wszystkich trzech (900-1010 wobec 970 sekund), bo błędy przy różnych awariach się znoszą. Wniosek o kredyt wymaga jednak dokładnego początku i końca każdej awarii, a skrypt sprawdzający co 5 minut może się pomylić nawet o 5 minut z każdej strony.
Dla Twojego monitoringu hostingu oznacza to: interwał 60 sekund lub krótszy, sprawdzanie z dwóch lub trzech lokalizacji poza Twoim hostingiem, alert po dwóch nieudanych sprawdzeniach z rzędu, sprawdzanie słowa kluczowego na stronie zamiast samego statusu 200 i log w UTC przechowywany co najmniej dwa miesiące, bo tyle trwają terminy zgłoszeń. Najprostsza opcja na dowolnym serwerze z cronem:
#!/bin/bash
# uptime-check.sh URL LOG: one check, one line in the log
URL=$1; LOG=$2
res=$(curl -s -o /dev/null -m 10 -w '%{http_code} %{time_total}' "$URL")
echo "$(date -u +%FT%TZ) $res" >> "$LOG"

# crontab -e: every minute
* * * * * $HOME/uptime-check.sh https://example.com/ $HOME/uptime.log

# uptime from the log
$ awk '{n++; if ($2!=200) f++} END {printf "checks %d, failed %d, uptime %.3f%%\n", n, f, 100*(n-f)/n}' uptime.log
checks 4, failed 1, uptime 75.000%
Jeśli uruchomisz ten skrypt na tym samym serwerze co strona, nie zauważy awarii całego serwera, więc uruchom go na innej maszynie albo skorzystaj z zewnętrznej usługi monitoringu.
Jeśli X, zrób Y
| Sytuacja | Co zrobić |
|---|---|
| Dostawca reklamuje „99,9% uptime”, ale nie ma dokumentu SLA | Zapytaj na piśmie: co liczy się jako przestój, jak jest mierzony, co jest wyłączone, jaki jest kredyt i termin zgłoszenia |
| Godzina przestoju kosztuje Cię więcej niż miesiąc hostingu | Nie licz na kredyty; zainwestuj w monitoring, kopie zapasowe przechowywane poza głównym serwerem i plan odtworzenia |
| Twój monitor sprawdza stronę co 5 minut | Skróć interwał do 60 sekund lub mniej i ustaw alert po dwóch nieudanych sprawdzeniach z rzędu |
| Strona zwraca 500, ale dostawca twierdzi, że serwer działa | Zwykle nie jest to przestój w rozumieniu SLA; sprawdzaj słowo kluczowe na stronie, nie tylko status 200, i szukaj przyczyny w logach |
| Awaria właśnie trwa | Od razu otwórz zgłoszenie, zapisz czas w UTC i wykonaj kroki diagnostyczne z poradnika podanego wyżej |
| Strona jest celem ataku DDoS | Nie licz na kredyt: większość SLA wyłącza ataki; potrzebujesz osobnej ochrony przed serwerem |
| Dwóch dostawców obiecuje 99,9% | Porównaj definicję przestoju, limity prac serwisowych, publiczną historię incydentów i kilka tygodni danych z własnego monitoringu |
Więcej kryteriów wyboru znajdziesz w naszym poradniku o tym, jak wybrać niezawodny hosting (po angielsku). RichHost działa od 2003 roku i ma 4 centra danych TIER III w Helsinkach, Warszawie, Paryżu i USA, z ciągłymi kopiami zapasowymi w chmurze. Warunki dostępności i rekompensaty dla konkretnego planu sprawdzisz na stronie z planami hostingu lub zapytasz o nie support: działa w godzinach 10:00-20:00 czasu kijowskiego i odpowiada w około 30 minut.
FAQ
Ile minut przestoju dopuszcza 99,9% uptime?
43 minuty 12 sekund w miesiącu 30-dniowym, 44 minuty 38 sekund w miesiącu 31-dniowym i 8 godzin 45 minut 36 sekund w roku.
Czy dostawca zrekompensuje utracony przychód?
Nie. We wszystkich sześciu SLA z tabeli rekompensata to kredyt na przyszłe faktury, maksymalnie do wysokości miesięcznej opłaty za usługę. Hetzner i Google wprost piszą, że SLA nie daje żadnych innych środków.
Czy kredyty są przyznawane automatycznie?
Nie, u żadnego z sześciu dostawców. Trzeba złożyć wniosek z dowodami: w Hetznerze w ciągu 14 dni po końcu miesiąca, w OVHcloud i Google w ciągu 60 dni, w AWS i DigitalOcean do końca drugiego cyklu rozliczeniowego; hosting.com nie podaje terminu.
Jak często sprawdzać dostępność strony?
Co 60 sekund lub częściej, z kilku lokalizacji. Na naszym stanowisku testowym skrypt sprawdzający co 5 minut wykrył tylko 3 z 10 awarii, co minutę 8 z 10, a co 5 sekund wszystkie 10.
Czy atak DDoS liczy się w SLA jako przestój?
Zwykle nie. Hetzner, OVHcloud i hosting.com wprost wyłączają ataki, a w pozostałych SLA mieszczą się one w czynnikach poza kontrolą dostawcy.


